Чат с документами
Следующий шаг в обработке информации
Вместо того чтобы полагаться на общедоступные наборы данных и общие знания, «Чат с документами» генерирует контекстно-специфические ответы и анализы на основе ваших доверенных внутренних ресурсов. Загрузите ваши документы и используйте их как основу для ответов на вопросы в чате!
Решение проблемы ограничений данных
Если вы задаете вопросы языковой модели, вы зависите от набора данных, на котором обучена модель. Обычно это информация с интернета. Неб public источники, вероятно, не входят в этот набор. Используя ваши документы в качестве источника для чата, вы точно знаете, что у модели есть информация, необходимая для ответов на ваши вопросы.
Возможности с вашими документами
Вы можете задавать вопросы по вашим документам, например перечислять основные пункты документа или делать его резюме. Также можно поручить языковой модели выполнить конкретный анализ с использованием вашей собственной базы данных.
Недостатки документ-ориентированного чата
Загрузка документов и их обработка — это дополнительные шаги, которые вам не нужны, если можно получить удовлетворительный ответ без контекста конкретной информации. Также требуется больше времени на генерацию ответа, потому что нужно сначала извлечь необходимую информацию из документа, прежде чем запрос будет отправлен языковой модели.
Как узнать, какие источники были прочитаны
Под ответом Источники может показывать, какой контент использовала модель: Полный текст, Выборка, Краткое содержание, Обработан не полностью или Не прочитан. Прикреплённый файл, таким образом, не читается автоматически полностью. Проверьте эту информацию, прежде чем использовать ответ, который должен охватывать все части файла.
При выборке или сокращённом результате вы можете более целенаправленно попросить о главе или об оставшихся частях. При неполной обработке сначала проверьте статус файла. Администратор помощника может в Исходный текст выбрать Требуется полный исходный текст: тогда сводки не используются вместо текста. Крупные источники могут читаться по частям и требовать больше ресурсов. И в этом случае всё равно нужно проверять сообщение об источниках.
Выберите один или несколько документов
Вы можете включить режим файлов, нажав на скрепку справа от панели запроса. Вы можете выбрать до 10 файлов для чата.
На момент начала чата с документами проверяется, подходит ли языковая модель для чата с документами. Если нет, автоматически выбирается подходящая модель из актуального каталога.
Вы можете общаться с этими документами, пока режим файлов включен.
Обработка по каждому файлу
Помимо чата с документами, AI-Public также предоставляет возможность отдельно применять подсказку к каждому документу и получать индивидуальные ответы. Эта функция называется Обработка по каждому файлу.
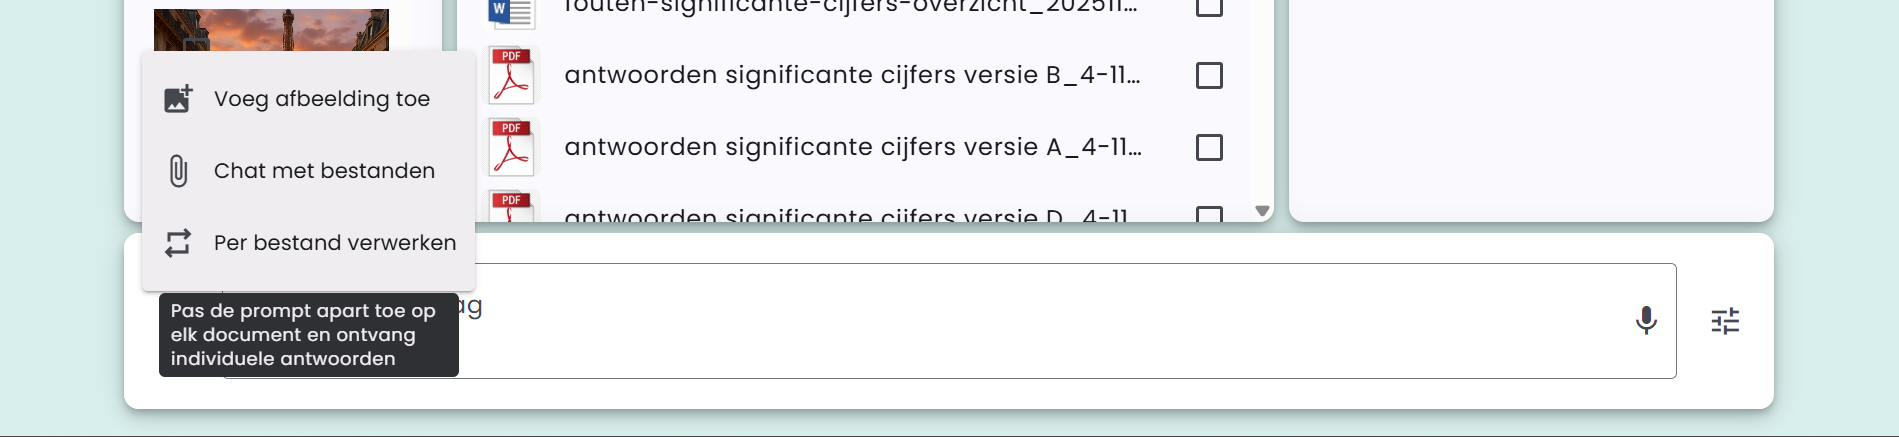
Эта функция может использоваться в сочетании с «Чат с файлами».
Вариант применения
Практический пример использования «Обработка по каждому файлу»:
- Вы загружаете справочный документ и включаете его в раздел Чат с файлами
- Вы загружаете несколько документов, которые нужно проанализировать, и включаете их в раздел Обработка по каждому файлу
- Вы формулируете подсказку, которая применяется к каждому файлу отдельно
Так вы, например, можете автоматически анализировать все документы на основе справочного документа.
Для функции «Обработка по каждому файлу» действует лимит в 30 файлов.
Поддерживаемые типы файлов
AI-Public поддерживает различные типы файлов для чатирования с документами:
- PDF-файлы (.pdf)
- Word документы (.docx)
- CSV-файлы (.csv)
- JSON-файлы (.json)
- Текстовые файлы (.txt)
- Аудио и видео файлы с расширениями 'mp3', 'mp4', 'mpeg', 'mpga', 'm4a', 'wav' или 'webm'
Чат с аудио- или видеофайлами
AI-School сначала транскрибирует аудио- и видеофайлы выбранным поставщиком транскрипции. В разговорах результат может содержать временные блоки и метки говорящих. Затем подходящая текстовая модель может исправить пунктуацию, орфографию, метки говорящих и специальные термины. Длинные файлы могут обрабатываться иначе из-за ограничений поставщика и модели.
Центральная база знаний
Опубликованные документы автоматически ищутся в пределах организации или школы и остаются собственностью организации.
- Создать документ Markdown
- Добавить исходный файл
- Импортировать пакет OKF / Экспортировать пакет OKF
- Статус публикации: Черновик, Опубликовано, Архивировано
- Область: Вся организация / Выбранные школы
Администраторы школ могут управлять документами только своих школ; администраторы организации также могут управлять знаниями на уровне всей организации.
Используйте YAML-frontmatter и обычные ссылки Markdown для переносимых знаний OKF.
