与文档的聊天
信息处理的下一步
与其依赖公开数据集和一般知识,“与文档聊天”基于你信任的内部来源,生成情境特定的答案和分析。上传你的文档并使用这些文档作为聊天中回答问题的基础!
解决数据限制
如果你向语言模型提问,你将依赖模型所训练的数据集。通常这些信息来自互联网。非公开来源很可能不在该数据集中。通过将你的文档用作聊天的来源,你可以确保模型具备回答你问题所需的信息。
使用你的文档的能力
你可以就你的文档提问,例如列出文档的要点或对文档进行摘要。你还可以让语言模型利用你自己的数据集执行特定分析。
文档驱动聊天的缺点
上传文档并处理它们需要额外步骤,这些步骤在你不需要特定信息上下文就能得到良好回答时就不必进行。此外,由于必须先从文档中提取所需信息再将请求发送给语言模型,生成回答的时间也更长。
查看已读取哪些来源
在回答下方,来源会显示模型使用了哪些内容:全文、节选、摘要、处理不完整或未读取。因此,附加文件并不会自动被完整读取。在使用需要涵盖文件所有部分的答案之前,请先检查此信息。
对于选择内容或截断结果,你可以更有针对性地要求某一章节或其余部分。对于处理不完整的情况,先检查文件状态。助手管理员可以在 源文本 中选择 要求完整源文本:这样摘要不会被用作正文的替代。大型来源可能会分段读取并消耗更多额度。即便如此,仍然需要检查来源提示。
选择一个或多个文档
你可以通过在问题输入框右侧点击回形针来开启文件模式。你可以最多选择 10 个文件来进行聊天。
当你开始与文档聊天时,会检查语言模型是否适合进行文档聊天。如果不合适,系统会自动从当前目录中选择一个合适的模型。
在开启文件模式时,你即可与这些文档聊天。
按文件处理
除了与文档聊天外,AI-Public 还提供在每个文档上单独应用提示并获取独立答案的功能。此功能称为 逐文件处理(Per bestand verwerken)。
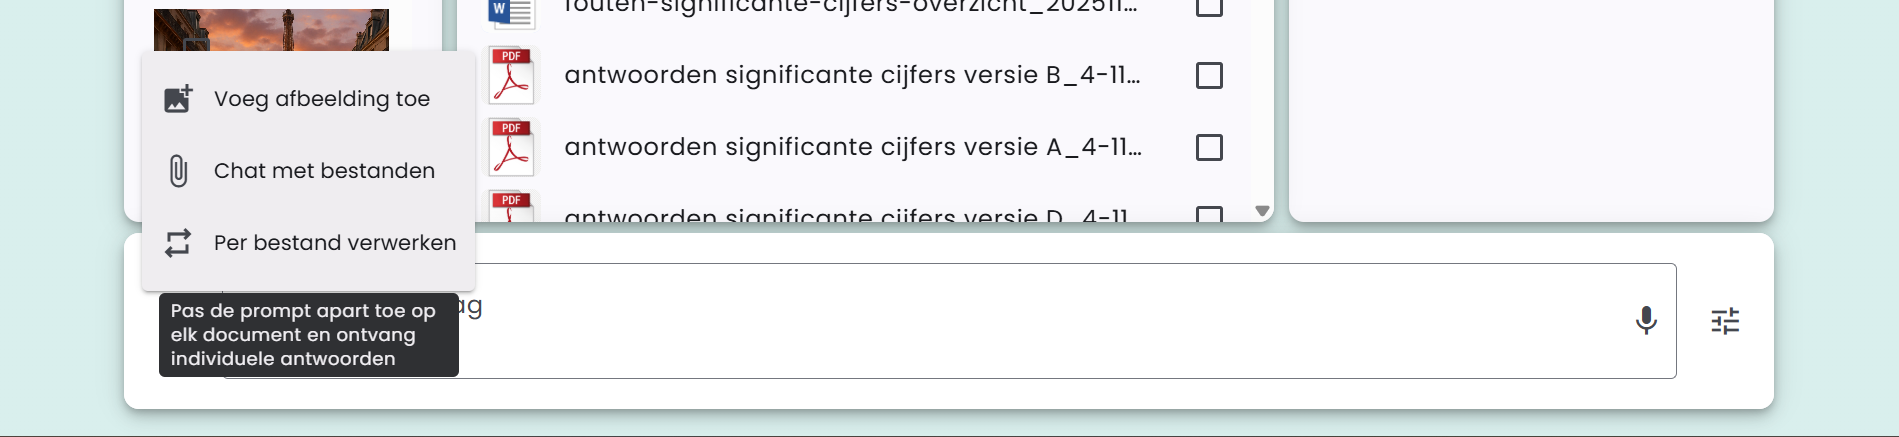
此功能可与“与文件聊天”组合使用。
可能的场景
一个使用 “逐文件处理” 的实际示例:
- 你上传参考文档并在“与文件聊天”中启用
- 你上传需要分析的多个文档并在“逐文件处理”中启用
- 你提出一个提示,该提示逐个应用于所有文件
通过这种方式,你可以让所有文档基于参考文档自动进行分析。
“逐文件处理”功能的最大文件数为 30。
支持的文件类型
AI-Public 支持多种用于文档聊天的文件类型:
- .pdf 的 PDF 文件
- .docx 的 Word 文件
- .csv 的 CSV 文件
- .json 的 JSON 文件
- .txt 的文本文件
- 带扩展名的音频和视频文件:mp3、mp4、mpeg、mpga、m4a、wav、webm
与音频或视频文件聊天
AI-School 会先用设置好的转录提供商把音频和视频文件转为文本。对于对话,结果可能包含时间块和说话人标签。之后可以用合适的文本模型修正标点、拼写、说话人标签和专业术语。由于提供商和模型限制,长文件的处理方式可能不同于短文件。
中央知识库
已发布的文档会在其组织或学校范围内自动检索,并始终归组织所有。
- 创建 Markdown 文档
- 添加源文件
- 导入 OKF 包 / 导出 OKF 包
- 发布状态: 草稿, 已发布, 已归档
- 范围: 整个组织 / 所选学校
学校管理员只能管理自己学校的文档;组织管理员还可以管理覆盖整个组织的知识。
使用 YAML 前置元数据和普通 Markdown 链接创建可移植的 OKF 知识。
